نتایج بیشتر...
آموزش تکنیکهای پیشرفته SQL server

توضیحات
در این مجموعه از سری نرم افزارهای آموزشی پارسیان به آموزش تکنیک های پیشرفته ذخیره و بازیابی اطلاعات در Sql server پرداخته می شود.
اگر تازه می خواهید با SQL server شروع به کار کنید از لینک زیر استفاده نمایید:
https://cafebazaar.ir/app/ir.tinasoft.parsian.sqlserver2012/?l=fa
و اگر با SQL server آشنا هستید و می خواهید تکنیک های پیشرفته آن را فرا بگیرید این برنامه را دانلود کنید.
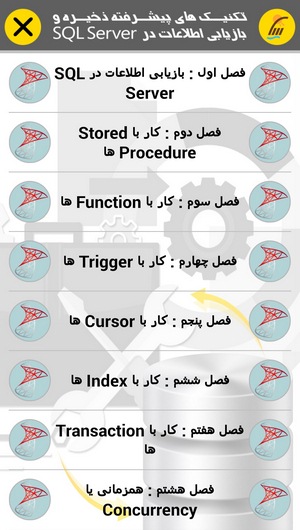
سرفصل های این برنامه عبارتند از:
فصل اول : بازیابی اطلاعات در SQL Server
جابجاکردن پایگاه های داده در SQL با استفاده از Attach
نحوه عملکرد دستور Backup
بازیابی فایل های Backup با استفاده از دستور Restore
یک مثال برای دستورات Backup و Restore
فصل دوم : کار با Stored Procedure ها
آشنایی با Stored Procedure ها
فرم کلی برای ایجاد Stored Procedure ها و اجرای آنها
پارامترهای درون Stored Procedure
پارامترهای درون Return Value یا مقدار بازگشتی
Output Parameters یا پارامترهای خروجی
امنیت در Stored Procedure ها
دسترسی به Stored Procedure ها بصورت گرافیکی
انواع Stored Procedure ها
فصل سوم : کار با Function ها
آشنایی با Function ها
کار با Scalar Function ها
کار با Table Function ها
ایجاد تغییرات در یک Function و حذف آن
کار با Function ها بصورت گرافیکی
جدول Sys.Object
فصل چهارم : کار با Trigger ها
آشنایی با Trigger ها
ساخت و استفاده از DML Trigger ها
مثال هایی راجع به DML Trigger ها
جداول Inserted و Deleted
استفاده از جداول Inserted و Deleted در چند نمونه
ایجاد تغییرات در یک Trigger و حذف آن
دسترسی به DML Trigger ها بصورت گرافیکی
Trigger های بازگشتی (Recursive) یا تودرتو
(Nasted)
کار با DDL Trigger ها
دسترسی گرافیکی به DDL Trigger ها
فصل پنجم : کار با Cursor ها
آشنایی با Cursor ها
انواع Cursor
فرم کلی تعریف یک Cursor
نحوه استفاده از Cursor ها
آشنایی بیشتر با دستور Fetch
به روز درآوردن و حذف کردن سطرها بوسیله یک Cursor
چند مثال در مورد Cursor ها
فصل ششم : کار با Index ها
آشنایی با Index ها
آشنایی با Clustered Index
آشنایی با Non Clustered Index
فرم کلی ایجاد Index ها
کار با Index ها بصورت گرافیکی
تاثیر Index ها بر روی Query ها
بازسازی Index ها
فصل هفتم : کار با Transaction ها
آشنایی با Transaction ها
تراکنش های صریح یا Explicit Transaction
استفاده از Save Point
تراکنش های ضمنی یا Implicit Transaction
تراکنش های خودکار یا Auto Commit Transaction
فصل هشتم : همزمانی یا Concurrency
آشنایی با انواع همزمانی ها
حالت همزمانی Last Update
همزمانی Dirty Read
همزمانی Non Repeatable Read
همزمانی Phantom Read
انواع روش های برخورد با همزمانی
آشنایی با Isolation Level ها
وقوع Dirty Read و نحوه مقابله با آن
وقوع Inconsistent Analysis و نحوه مقابله با آن
وقوع Phantom Read و نحوه مقابله با آن
استفاده از Snapshot Isolation Level
چگونگی وقوع Dead Lock
دستور Set Lock Timeout
انواع Lock ها در SQL Server
دستور Select … (nolock)
فصل نهم : امنیت کاربران و تعیین سطوح دسترسی
Authentication در SQL Server
آشنایی با تعدادی دستور در مورد Login ها
Roles یا نقش ها در SQL Server
آشنایی با تعدادی دستور در مورد Role ها
دستورات DCL
دستور Revoke و Deny
آشنایی با دو Stored Procedure سیستمی دیگر
فصل دهم : ایجاد گزارش با استفاده از Visual Studio
نحوه ایجاد گزارش
تهیه یک گزارش به عنوان نمونه
اضافه کردن جزئیات بیشتر به گزارش
از سایر
محصولات آموزشی نرم افزارهای شبکه و بانک اطلاعاتی
دیدن فرمایید.
محصولات مشابه
آموزش جامع شبکه
آموزش جامع بانکهای اطلاعاتی
آموزش جامع SQL server
آموزش جامع اندروید استودیو
آموزش جامع Visual C#.net
آموزش Visual Basic
آموزش طراحی برنامه های کاربردی VB
آموزش جامع Java Script
آموزش جامع C و ++C
آموزش کاربردی Net Components
آموزش برنامه نویسی با پاسکال
آموزش جامع HTML
آموزش جامع PHP
آموزشHTML و CSS


آموزش تکنیکهای پیشرفته SQL Server
SQL Server یکی از محبوبترین سیستمهای مدیریت پایگاه دادههای رابطهای (RDBMS) است که توسط مایکروسافت توسعه داده شده است. این نرمافزار برای ذخیرهسازی و مدیریت دادهها در برنامههای مختلف استفاده میشود. تکنیکهای پیشرفته SQL Server به شما کمک میکنند که کارایی سیستم را افزایش دهید، عملکرد کوئریها را بهینه کنید و قابلیتهای پایگاه داده را بهطور مؤثرتر مدیریت کنید.
در این آموزش، به برخی از تکنیکهای پیشرفته در SQL Server خواهیم پرداخت.
۱. استفاده از ایندکسها (Indexes)
ایندکسها ساختارهای دادهای هستند که به پایگاه داده کمک میکنند تا جستجوها و عملیات خواندن دادهها را سریعتر انجام دهند. ایندکسها مانند فهرستهایی برای جداول عمل میکنند.
انواع ایندکسها:
-
ایندکسهای معمولی (Clustered Indexes): در این ایندکس، دادههای واقعی در همان ساختار ایندکس ذخیره میشوند. هر جدول میتواند فقط یک ایندکس clustered داشته باشد.
-
ایندکسهای غیرمتمرکز (Non-Clustered Indexes): این ایندکسها دادهها را بهصورت جداگانه ذخیره میکنند و در واقع یک اشارهگر به دادههای واقعی هستند. یک جدول میتواند چندین ایندکس غیرمتمرکز داشته باشد.
نکات مهم برای استفاده بهینه از ایندکسها:
-
ایندکسها باعث افزایش سرعت جستجو میشوند، اما برای عملیاتهای نوشتن (INSERT، UPDATE، DELETE) ممکن است کندی ایجاد کنند.
-
انتخاب ایندکس باید با دقت صورت گیرد تا فقط بر روی ستونهایی که اغلب در شرایط جستجو و فیلتر استفاده میشوند، ایندکس ایجاد شود.
۲. بهینهسازی کوئریها (Query Optimization)
استفاده از Execution Plan: SQL Server یک ابزار به نام Execution Plan برای بررسی نحوه اجرای یک کوئری در اختیار شما قرار میدهد. این ابزار به شما کمک میکند تا بخشهای ناکارآمد یک کوئری را شناسایی کرده و آنها را بهینه کنید.
برای مشاهده Execution Plan:
-
در SQL Server Management Studio (SSMS)، پس از نوشتن کوئری، گزینه “Include Actual Execution Plan” را فعال کرده و سپس کوئری را اجرا کنید.
استفاده از ایندکسهای مناسب: یکی از عوامل اصلی کندی در اجرای کوئریها، استفاده نادرست از ایندکسها است. بررسی و استفاده صحیح از ایندکسها در اجرای سریعتر کوئریها تأثیر زیادی دارد.
استفاده از JOINها بهطور بهینه:
-
INNER JOIN سریعترین نوع JOIN است و معمولاً بهینهتر از سایر JOINها است.
-
OUTER JOIN باید فقط زمانی استفاده شود که واقعاً به اطلاعات گمشده (NULL) نیاز دارید.
استفاده از Subqueries و CTEs:
-
استفاده از Common Table Expressions (CTEs) برای بهبود خوانایی کوئریها و استفاده از آن در کوئریهای پیچیده.
-
سعی کنید از Subqueries بهصورت درونخطی (Inline) استفاده کنید تا نیازی به استفاده از Subqueryهای پیچیده نداشته باشید.
۳. Normalization و Denormalization
-
Normalization: فرایند طراحی پایگاه داده بهگونهای است که دادهها بدون تکرار و بهینه ذخیره شوند. این باعث کاهش حجم داده و بهبود یکپارچگی دادهها میشود.
-
Denormalization: گاهی اوقات برای بهبود عملکرد، دادهها بهطور عمدی در پایگاه داده تکرار میشوند. این کار میتواند سرعت جستجو را افزایش دهد، اما منجر به افزایش حجم دادهها و مشکلات نگهداری میشود.
تکنیکهای اصلاح ساختار پایگاه داده:
-
در شرایطی که جستجوهای پیچیده با تعداد زیاد JOINها انجام میدهید، ممکن است بخواهید از Denormalization استفاده کنید تا عملکرد کوئریها را بهبود دهید.
-
همیشه باید تعادل مناسبی بین Normalization و Denormalization پیدا کنید تا هم از یکپارچگی دادهها محافظت کنید و هم عملکرد بهینه را حفظ نمایید.
۴. تراکنشها و مدیریت قفلها (Transactions and Locks)
تراکنشها (Transactions): تراکنشها به شما این امکان را میدهند که چندین عملیات در یک بلوک بهطور اتمیک انجام شوند. بهعبارتدیگر، تمام عملیات یا بهطور کامل انجام میشوند یا اصلاً انجام نمیشوند.
ویژگیهای یک تراکنش:
-
Atomicity: تمام یا هیچ.
-
Consistency: پایگاه داده همیشه در یک وضعیت معتبر باقی میماند.
-
Isolation: عملیاتهای یک تراکنش از عملیاتهای دیگر تراکنشها مستقل هستند.
-
Durability: پس از تکمیل تراکنش، دادهها حفظ میشوند.
برای مدیریت تراکنشها از دستورات BEGIN TRANSACTION, COMMIT, و ROLLBACK استفاده میشود.
قفلها (Locks): SQL Server از مکانیزم قفل برای جلوگیری از دسترسی همزمان به دادهها استفاده میکند. مدیریت درست قفلها میتواند از بلوکه شدن تراکنشها جلوگیری کند.
انواع قفلها:
-
Shared Locks (S): برای عملیات خواندن دادهها.
-
Exclusive Locks (X): برای عملیات نوشتن دادهها.
-
Update Locks (U): برای جلوگیری از مشکلات در عملیاتهای UPDATE.
Deadlock: Deadlock زمانی رخ میدهد که دو یا چند تراکنش بهطور همزمان بر روی منابع خاصی قفل میزنند و هیچکدام نمیتوانند بهدرستی به نتیجه برسند. SQL Server ابزارهایی برای شناسایی و مدیریت deadlockها دارد.
۵. کار با Stored Procedures و Triggers
-
Stored Procedures: اینها کوئریهای از پیش نوشتهشدهای هستند که میتوانند برای انجام عملیاتهای پیچیده بهطور مکرر استفاده شوند. استفاده از Stored Procedures به شما این امکان را میدهد که عملیاتهای پیچیده را به صورت یکپارچه و قابل مدیریت انجام دهید.
-
Triggers: اینها عملیاتهایی هستند که بهطور خودکار پس از رخ دادن یک رویداد خاص (مانند INSERT، UPDATE یا DELETE) در یک جدول اجرا میشوند.
مزایای استفاده از Stored Procedures و Triggers:
-
کاهش تکرار کد.
-
مدیریت بهتر خطاها.
-
بهبود امنیت، زیرا از دسترسی مستقیم به دادهها جلوگیری میشود.
۶. استفاده از Partitioning برای جداول بزرگ
Partitioning روشی است برای تقسیم جداول بزرگ به بخشهای کوچکتر بهطوریکه بهراحتی قابل مدیریت و جستجو باشند. این کار بهویژه برای جداولی که دادههای زیادی دارند و معمولاً عملیاتهای SELECT روی بخشهای خاصی از دادهها انجام میشود، مفید است.
انواع Partitioning:
-
Horizontal Partitioning: تقسیم دادهها بر اساس ردیفها (مانند تقسیم دادهها بر اساس تاریخ).
-
Vertical Partitioning: تقسیم دادهها بر اساس ستونها (برای جداول با تعداد زیاد ستون).
۷. بهینهسازی عملکرد با استفاده از SQL Server Profiler
SQL Server Profiler یک ابزار مهم برای شناسایی مشکلات عملکرد و نظارت بر رفتار کوئریها است. با استفاده از SQL Server Profiler میتوانید:
-
شناسایی کوئریهایی که بیش از حد طول میکشند.
-
ردیابی منابع استفادهشده توسط کوئریها.
-
تجزیه و تحلیل Deadlockها و مشکلات موازی.
۸. استفاده از In-Memory OLTP
SQL Server ویژگی In-Memory OLTP را ارائه میدهد که امکان پردازش سریعتر دادهها را از طریق ذخیرهسازی دادهها در حافظه (RAM) فراهم میآورد. این تکنیک میتواند به طور قابل توجهی عملکرد کوئریها و عملیاتهای تراکنش را بهبود دهد.
این ویژگی بهویژه برای بارهای کاری با حجم بالا و نیاز به عملکرد سریع مناسب است.